WorkでCSVを整理するなら「元ファイルは残して、別名で」
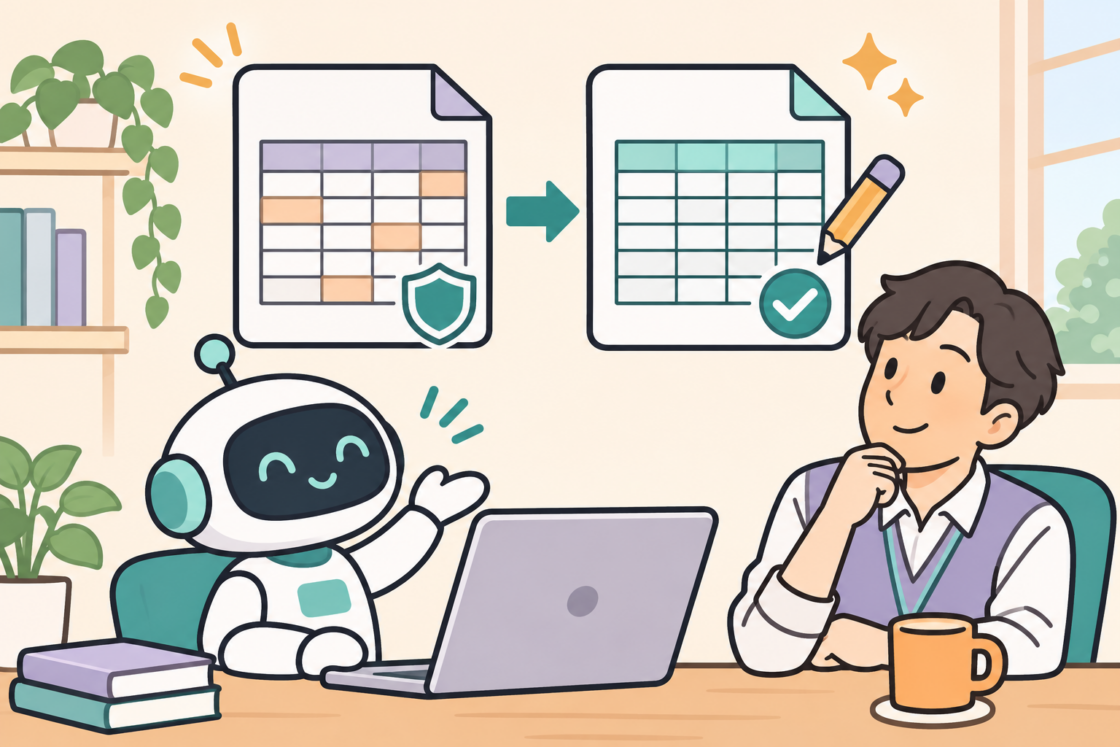
商品一覧や申込データのCSVを、ChatGPT Workで整理したい。そんなときは「きれいにして」だけでなく、「元ファイルは変更せず、別名のファイルで返して」と添えてみましょう。元データと結果を並べて確認できるようにする、地味ですが大事な一文です。
まず、何を変えるかを小さく決める
Workでは、元の資料を渡してファイルの作成や修正を依頼できます。ただし「整理」の意味は人によって違います。空欄を埋めるのか、重複を除くのか、並べ替えるのか。最初は一つの処理に絞り、変えてほしくないものも書くと確認しやすくなります。
たとえば、全列の値が同じレコードだけを重複として除くなら、次のように頼めます。ファイル名は例なので、添付したCSVに合わせて置き換えてください。
添付した items.csv を確認し、全列の値が完全に同じレコードだけを重複として除いてください。
同じものは最初の1件を残し、残るレコードの順番は変えないでください。
元ファイルは変更せず、結果を items-cleaned.csv という別ファイルで返してください。
列名・列の順番・各セルの文字列は変更せず、空欄の補完や表記統一は行わないでください。
商品コードなどの先頭の0も保持してください。文字コードは元ファイルに合わせ、不明な場合は推測して変換せず知らせてください。
最後に、ヘッダーを除いた処理前後の件数、除いた件数、出力ファイル名、実施した確認を報告してください。
「別名」と「変更の報告」をセットにする
元ファイルを手元にも残しておけば、判断を誤ったときにやり直せます。出力名を指定するのは、元データと整理済みデータを取り違えないため。さらに件数と処理内容を報告してもらうと、どこを確認するかの手掛かりになります。
全列一致を指定した場合、同じ商品コードでも他の列が違えば別のレコードです。反対に、業務上は必要な同一内容の記録もあり得るので、「同じ行だから不要」とは限りません。重複の判定ルールは、データの用途に合わせて決めてください。
完了メッセージだけでなく、出力を開く
受け取ったファイルは、まず別名で保存されているかを確認し、列名・件数・日本語の表示・商品コードなどを元データと見比べます。件数はヘッダーを除いたレコード数でそろえ、「処理前−除いた件数=処理後」になっているかも確認しましょう。
指示を添えても、正しく処理される保証にはなりません。最初は匿名化した小さなサンプルで試すのがおすすめです。業務データを渡す際は所属先のルールに従い、不要な個人情報は含めないようにします。ファイル作成や表示の機能は利用環境によって異なるため、実際に使える機能を確認してください。
参照:OpenAI公式ドキュメント「Work with files」(2026年11月16日確認)。CSV整理のプロンプトと確認項目は、本記事用に作成した例です。